RAG Platform
Документи всередину, обґрунтовані відповіді назовні - і числа, які кажуть, чи добрий пошук.
- Роль
- Єдиний інженер: архітектура, бекенд, фронтенд, оцінювання, інфраструктура
- Період
- 2025 - 2026
- Статус
- Працює, за запрошенням
- Працює на
- rag-platform.reldava.comТільки за запрошенням, і це задумано
- Код
- zk2/zk2-rag-platformВідкритий код, MIT
Цікаве тут не те, що воно відповідає на питання. Цікаве те, що кожне неочевидне рішення записане поруч з кодом, який його втілив, і що ці рішення закриті вимірюванням, а не смаком.
7
метрик оцінювання
чотири детерміновані, три судить модель
7
типів вузлів пайплайна
кожен налаштовується зі своєї схеми
4
провайдери моделей
за одним інтерфейсом
-27%
вхідних токенів
та сама якість відповіді, з реранком
Задача
RAG легко показати і важко довіряти. Демо добре відповідає на три питання; корпус реальних документів дає відповіді, які ніхто не може перевірити, з фрагментів, яких ніхто не бачить, за вартість, яку ніхто не рахував.
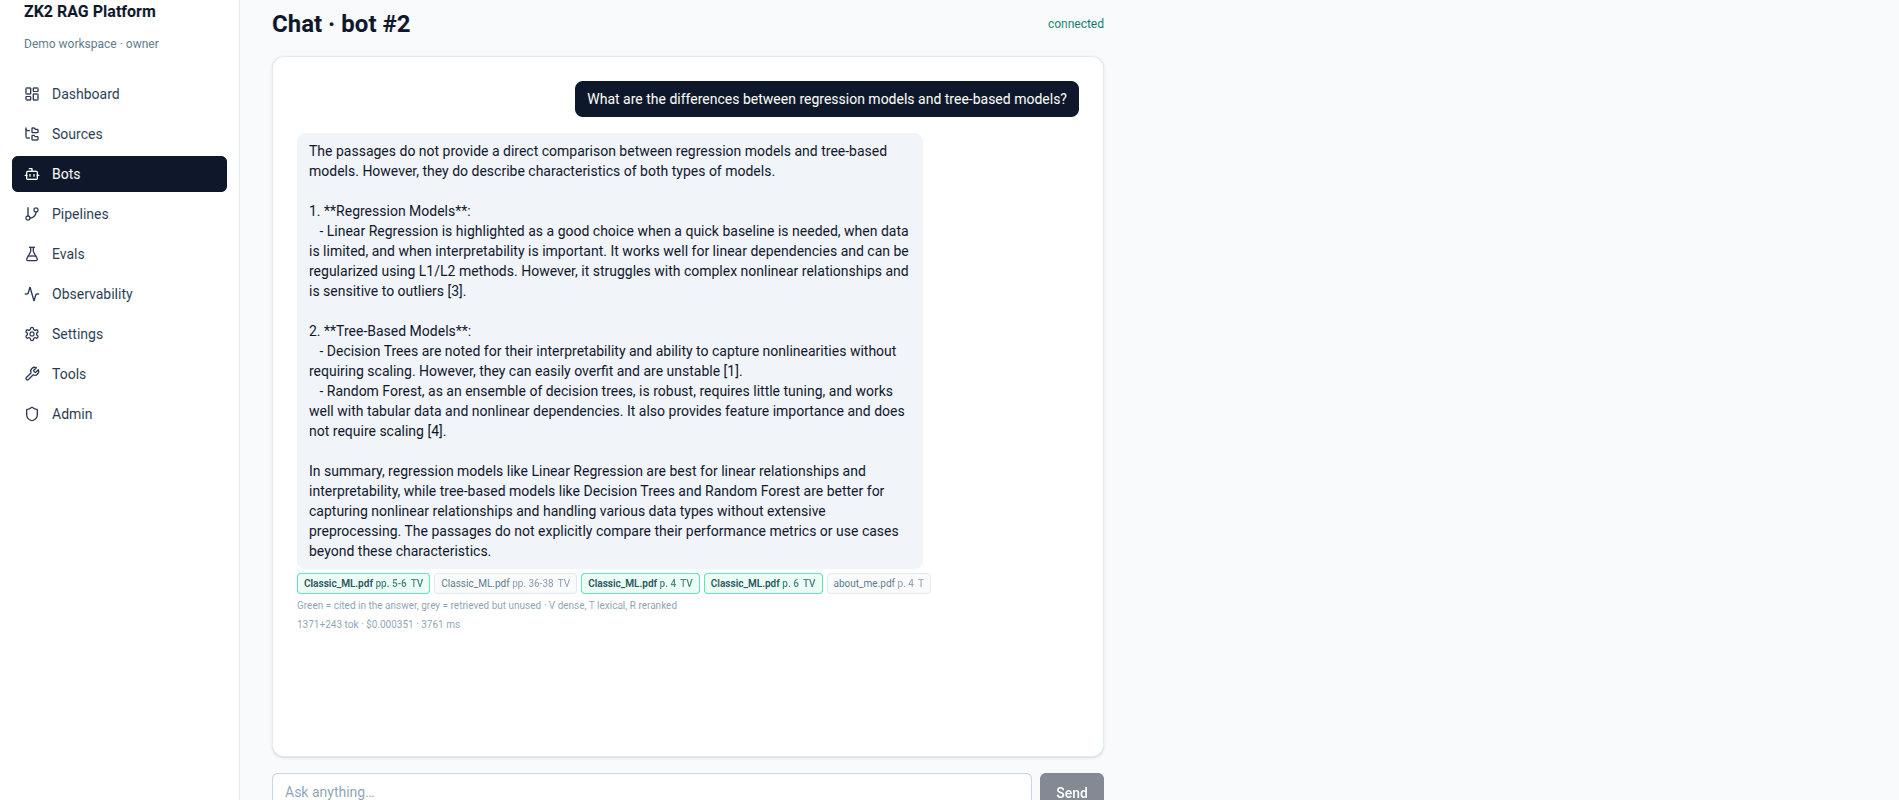
Тому платформа побудована навколо того, що демо пропускає: звідки насправді взялася цитата, що зміна в пайплайні зробила з відповідями і скільки все це коштує на одне питання.
Інгест, який зберігає структуру
Сім форматів - PDF, DOCX, XLSX, HTML, Markdown, JSON, простий текст - і кожен лоадер повертає структуру, яку формат реально декларує, а не суцільну стіну тексту. У PDF немає заголовків, є лише кегль, тому заголовки читаються з розміру шрифту, який документ використовує сам. У Word є стилі заголовків. В HTML є h1, а main важливіший за обрамлення сторінки.
Далі чанки пакуються під бюджет токенів, а не ріжуться на кожній межі, бо заголовок каже, що змінилася тема, а не що тексту вже достатньо для відповіді. Кожен чанк несе сторінку і шлях заголовків, на які він чесно може претендувати, - саме це дозволяє цитаті назвати сторінку, а не порядковий номер.
Пошук у множині
pgvector для змісту і повнотекстовий пошук Postgres для точних термінів, злиті за reciprocal rank. Кожен документ індексується своєю мовою, визначеною при інгесті, тому до російського тексту застосовується російський стемінг, а до англійського - англійський.
Запит будується так, щоб збігтися з будь-яким зі своїх значущих слів, і стоп-слова всіх налаштованих мов прибираються першими: з'єднати їх усі через AND, що й робить наївний хелпер Postgres, означає не знайти нічого на реальному питанні. Багатомовний крос-енкодер реранкер їде всередині образу і працює на CPU, тому перше питання не стає ще й першим завантаженням моделі.
Пайплайн - це дані
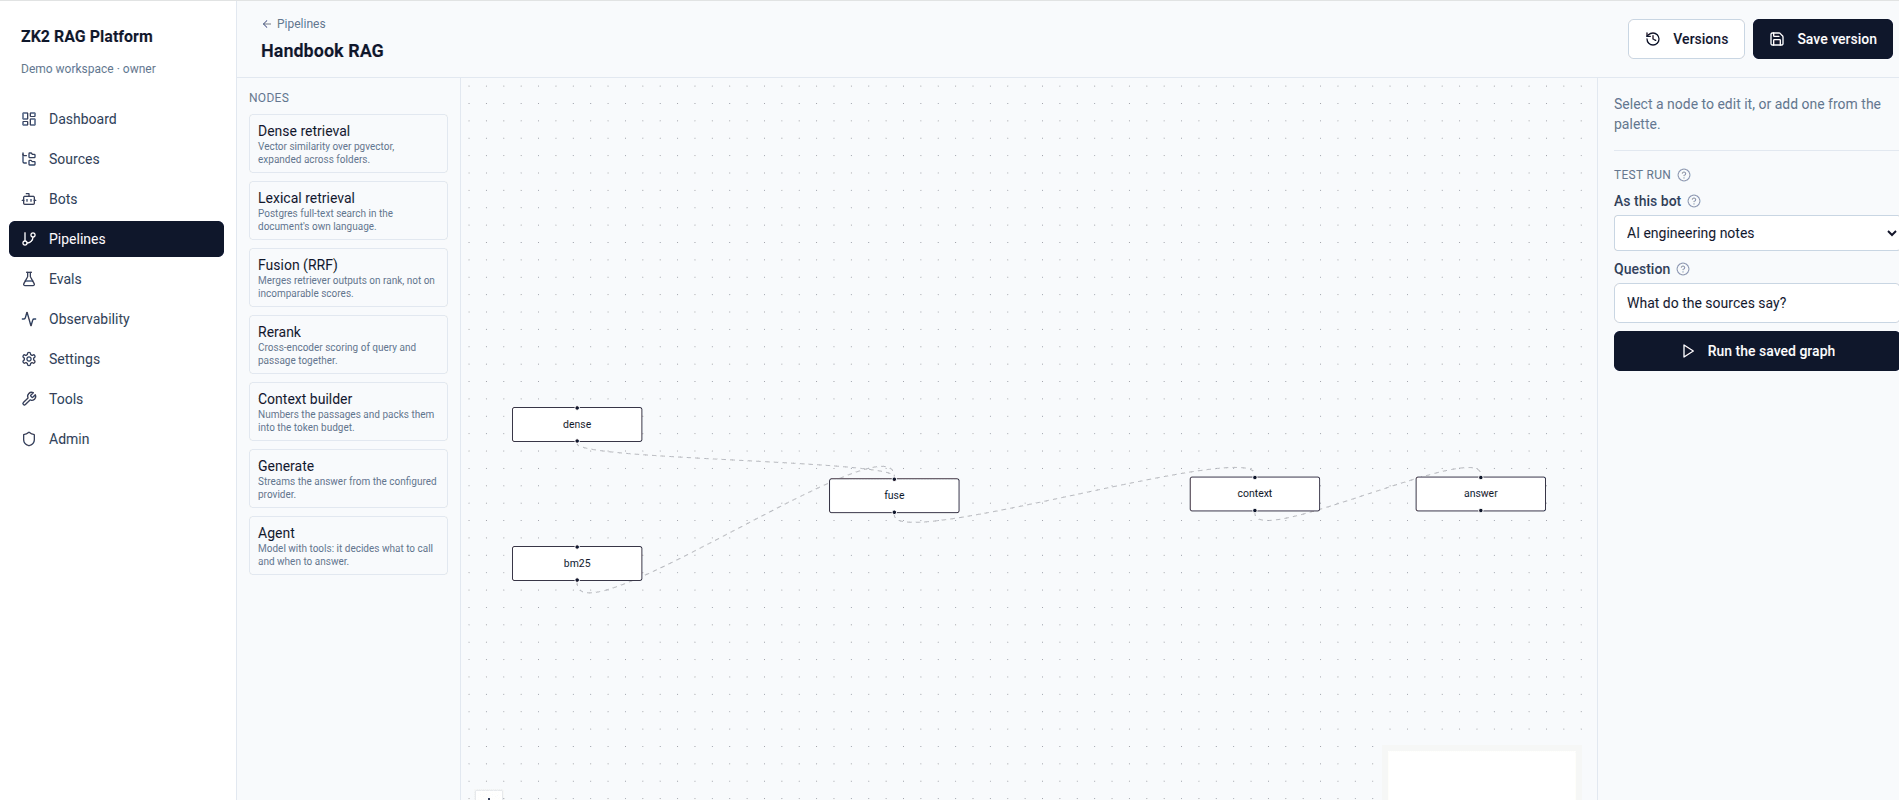
Пайплайн пошуку - це JSON-документ з вузлів і ребер, який рантайм виконує, а канва на React Flow редагує. Сім типів вузлів - щільний пошук, лексичний пошук, злиття, реранк, збирач контексту, генерація, агент - і кожен генерує свою форму налаштувань з власної JSON Schema, тому форма і валідація походять з однієї декларації.
Версії - незмінні знімки з мітками; одна поточна, і саме її віддають боти. Чернетку можна прогнати на реальному боті до збереження, а граф, частини якого не з'єднані, відхиляється, замість тихо відповідати взагалі без контексту.
Суперечки, закриті числами
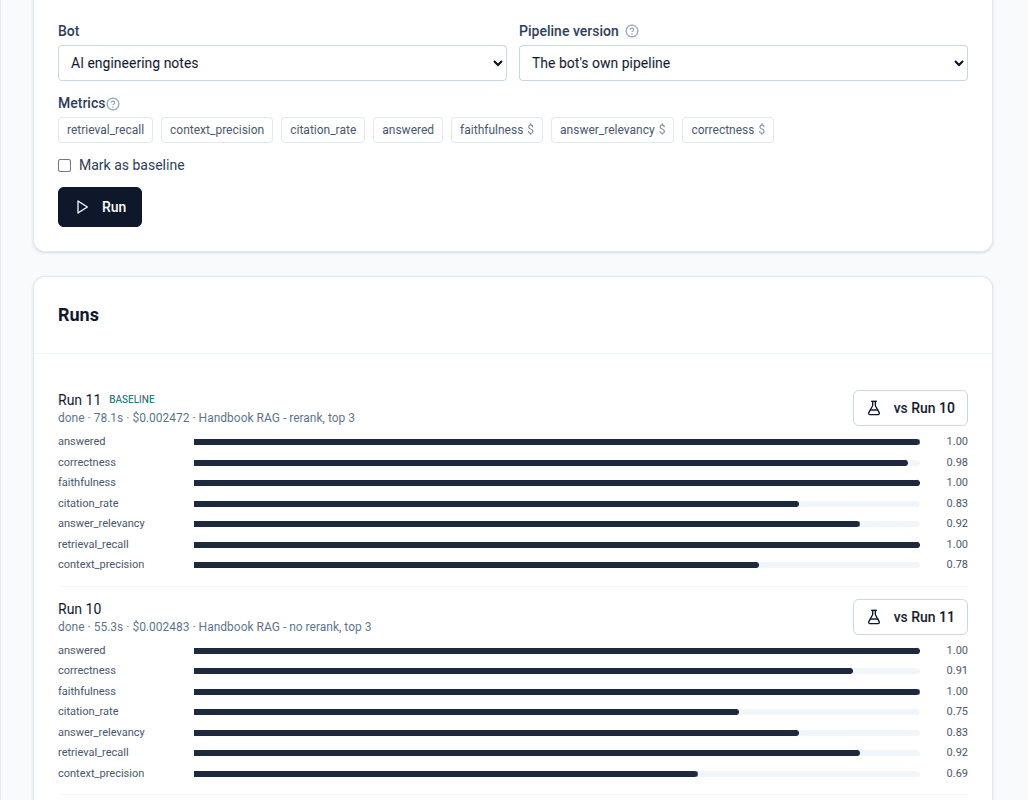
Еталонний набір - це питання, відповіді на які вже відомі, і документ, з якого кожна має прийти. Він проганяється через реальний пайплайн - той самий виконавець, що й у звичайному чаті, - і рахує сім метрик: чотири детерміновані й безкоштовні, три судить модель, і вони позначені як платні.
Прогон можна закріпити за конкретною версією пайплайна, тому два графи порівнюються на тих самих питаннях і тому самому боті, а будь-які два прогони можна зіставити з поіменованими регресіями. На живому трафіку A/B-експеримент ділить розмови між поточною версією і кандидатом, липко для кожної людини, а ходи, токени і витрати по гілках беруться з тих самих подій використання, які читає білінг.
Чотири інструменти, чотири питання
Langfuse знає, що модель побачила, що відповіла і скільки це коштувало. Jaeger знає, куди пішов час усередині одного запиту, включно з SQL і HTTP, яких Langfuse не бачить. Prometheus єдиний відповідає на питання не про конкретний запит - глибина черги, частота помилок за годину, p95 минулого вівторка. Grafana - це те, як воно виглядає, і коли когось треба будити.
Витрати по організаціях свідомо не є метрикою: мітки ніколи не несуть ідентичність тенанта, бо часовий ряд на кожного клієнта - це те, від чого вмирає бекенд метрик. На це питання відповідає таблиця використання в Postgres, і міркування записані в ADR.
Що вирішило вимірювання
Три суперечки, які інакше закрив би той, хто говорив останнім. Кожна прогнана на реальному виконавці по еталонному набору на реальному корпусі, з зафіксованим графом, щоб гілки відрізнялися рівно однією річчю.
Який реранкер узагалі можна запустити
Очевидний варіант за замовчуванням - крос-енкодер на 568M - витрачав тридцять секунд на ранжування тридцяти кандидатів на CPU, тоді як хід загалом триває дві-чотири секунди. Багатомовна модель на 118M робила ту саму роботу за три з половиною і так само часто ставила потрібний фрагмент у топ-2. Велика модель була не повільним вибором, а неможливим.
Чи вартий реранк своєї секунди
Три фрагменти з реранкером дорівнювали п'яти без нього за всіма метриками відповіді, при на 27 відсотків меншому вході. Він не купує кращу відповідь на п'яти фрагментах - він робить безпечними три. А чи варте це 1.26 секунди на питання, залежить від ціни моделі і від того, чи хтось чекає.
Чому прогон повідомляє сім метрик, а не одну
В одній гілці context precision зросла, поки всі метрики відповіді впали, бо найважче питання випало із середнього разом зі своєю низькою оцінкою. Оптимізація єдиного числа зсередини виглядає саме так.
Коли еталонний набір не може вирішити - зазвичай тому, що його питання не ті, які ставлять живі люди, - те саме порівняння виходить на живий трафік як A/B: липко для кожної людини, з контролем, зафіксованим на старті експерименту, і з ходами, токенами та витратами по гілках з тих самих подій використання, які читає білінг.
Стек
- FastAPI
- Python 3.12
- PostgreSQL 16
- pgvector
- Postgres FTS
- ltree
- Redis 7
- Arq
- Next.js 15
- React Flow
- LangGraph
- MCP
- OpenAI
- Anthropic
- Gemini
- Ollama
- Prometheus
- Grafana
- OpenTelemetry
- Langfuse
- Helm
- Terraform
- Playwright
Розкажіть, що ви будуєте
Для початку достатньо опису задачі. Якщо це моє - скажу, що б я побудував, скільки це приблизно займе і чого робити не став би.
Обговорити задачу